

常见玩法,挑一种做
做AI对口型之前,先想好要哪一种。传照片还是视频、用哪个模型,跟着就定了。
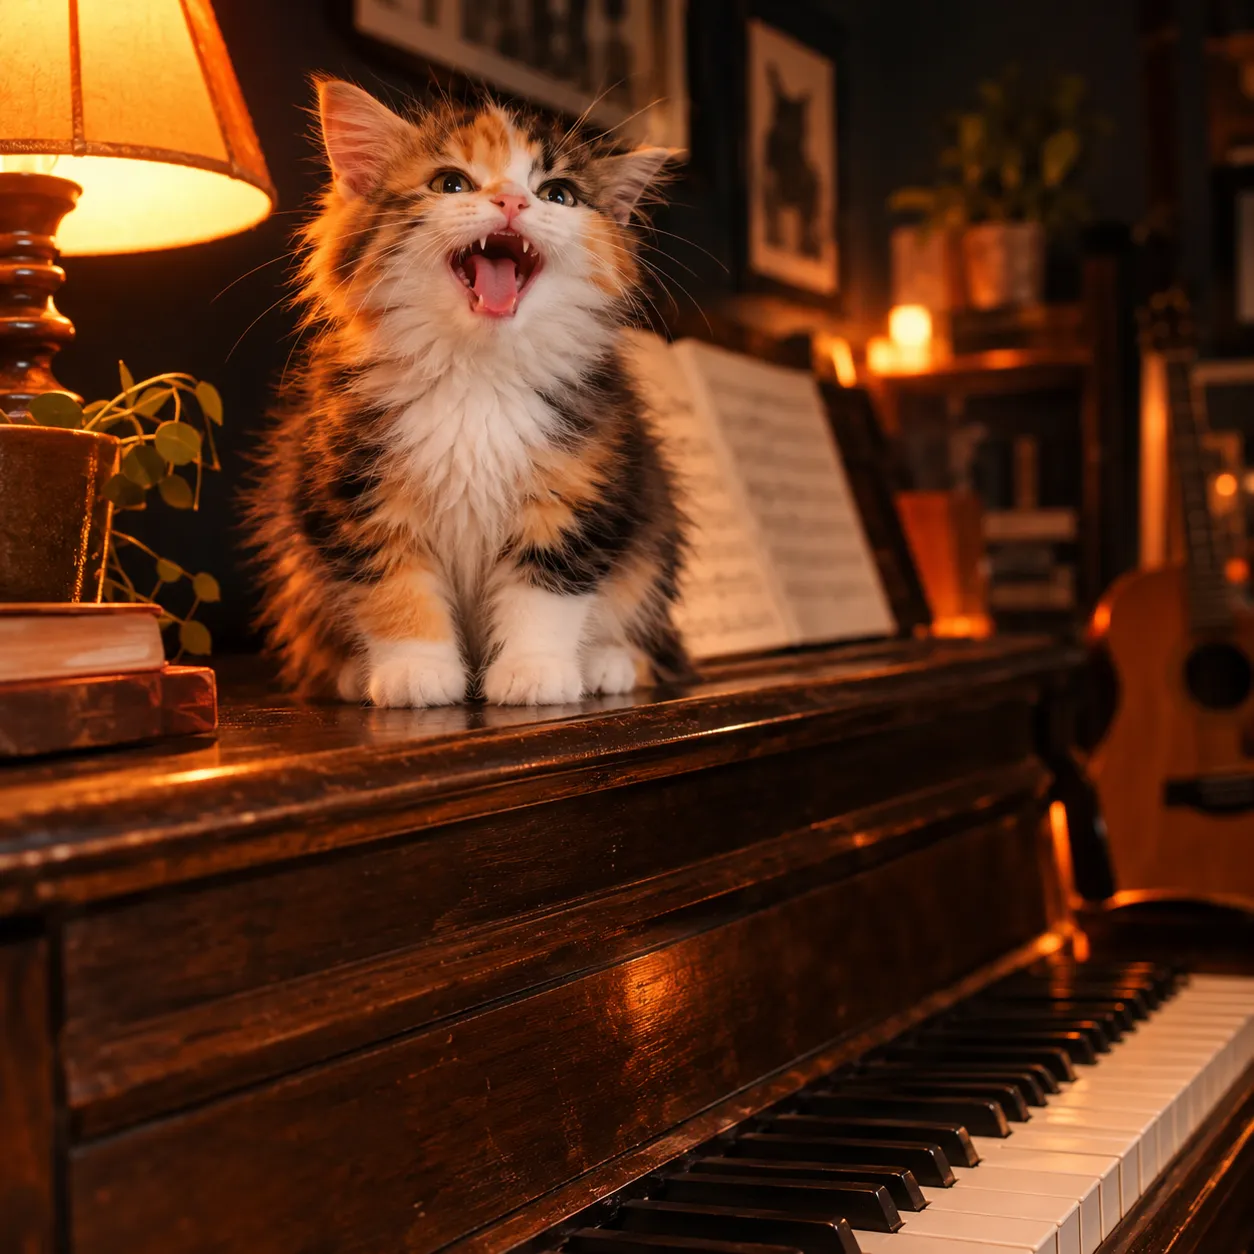 照片唱歌
宠物照片唱歌
- 上传
- 脸清楚的照片,加一段歌
- 先试
- 以工具内显示为准
- 小提醒
- 截副歌那几句,短一点好挑
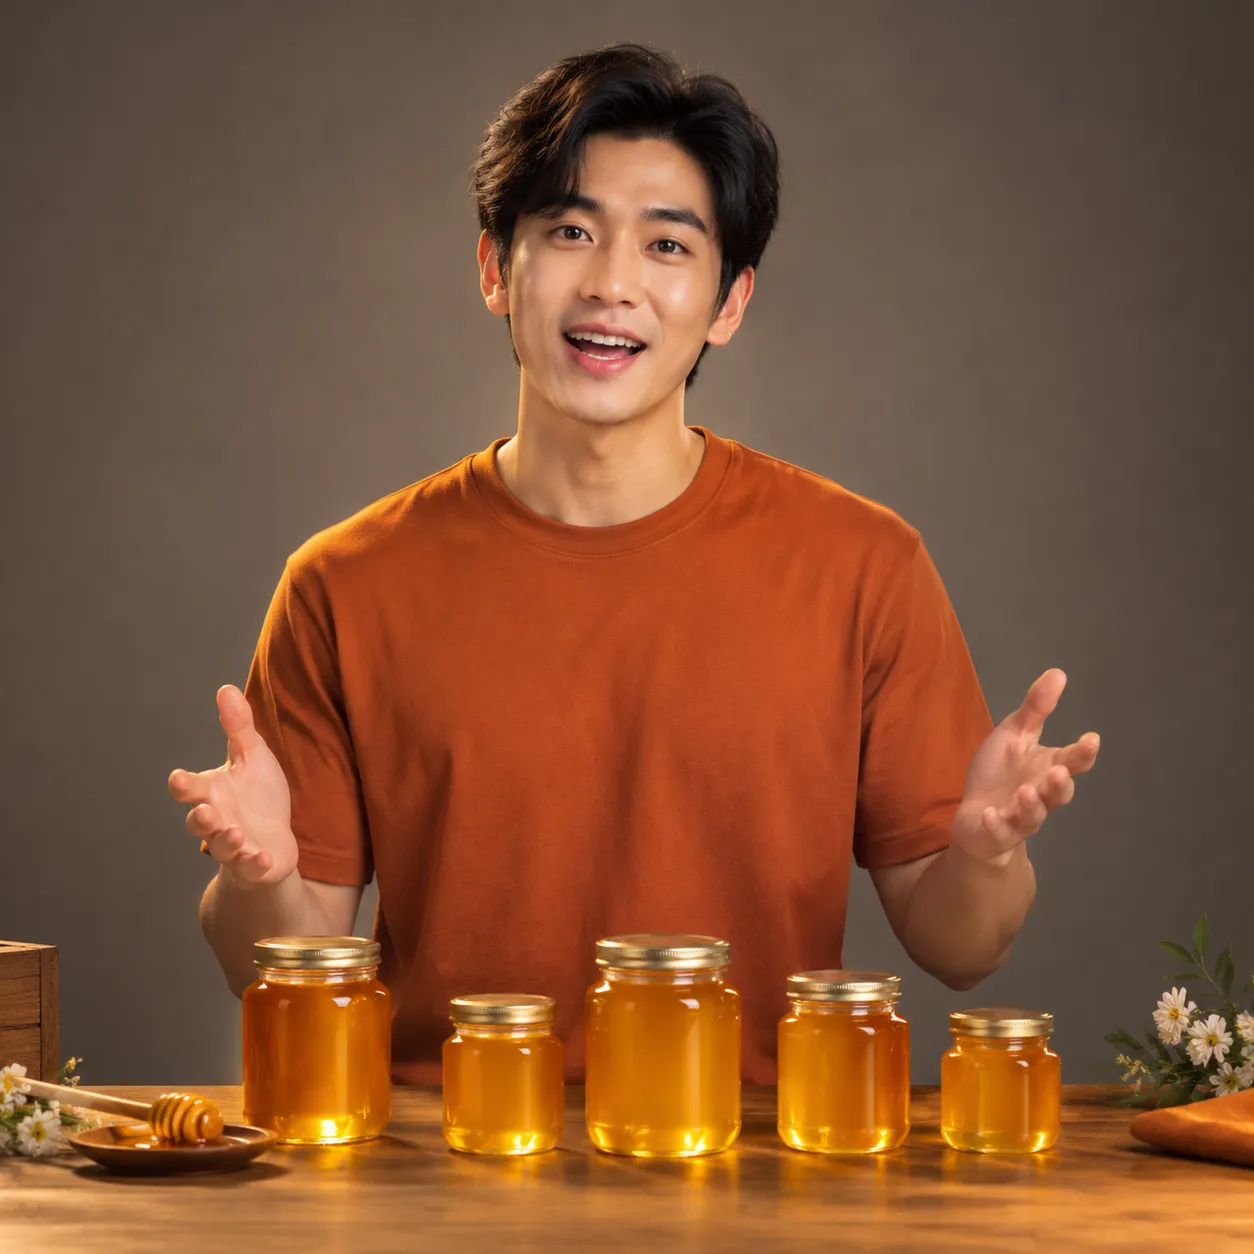 口播换词
口播换台词
- 上传
- 正对镜头的口播视频,加新台词录音
- 先试
- 以工具内显示为准
- 小提醒
- 价格、功效要和实物一致
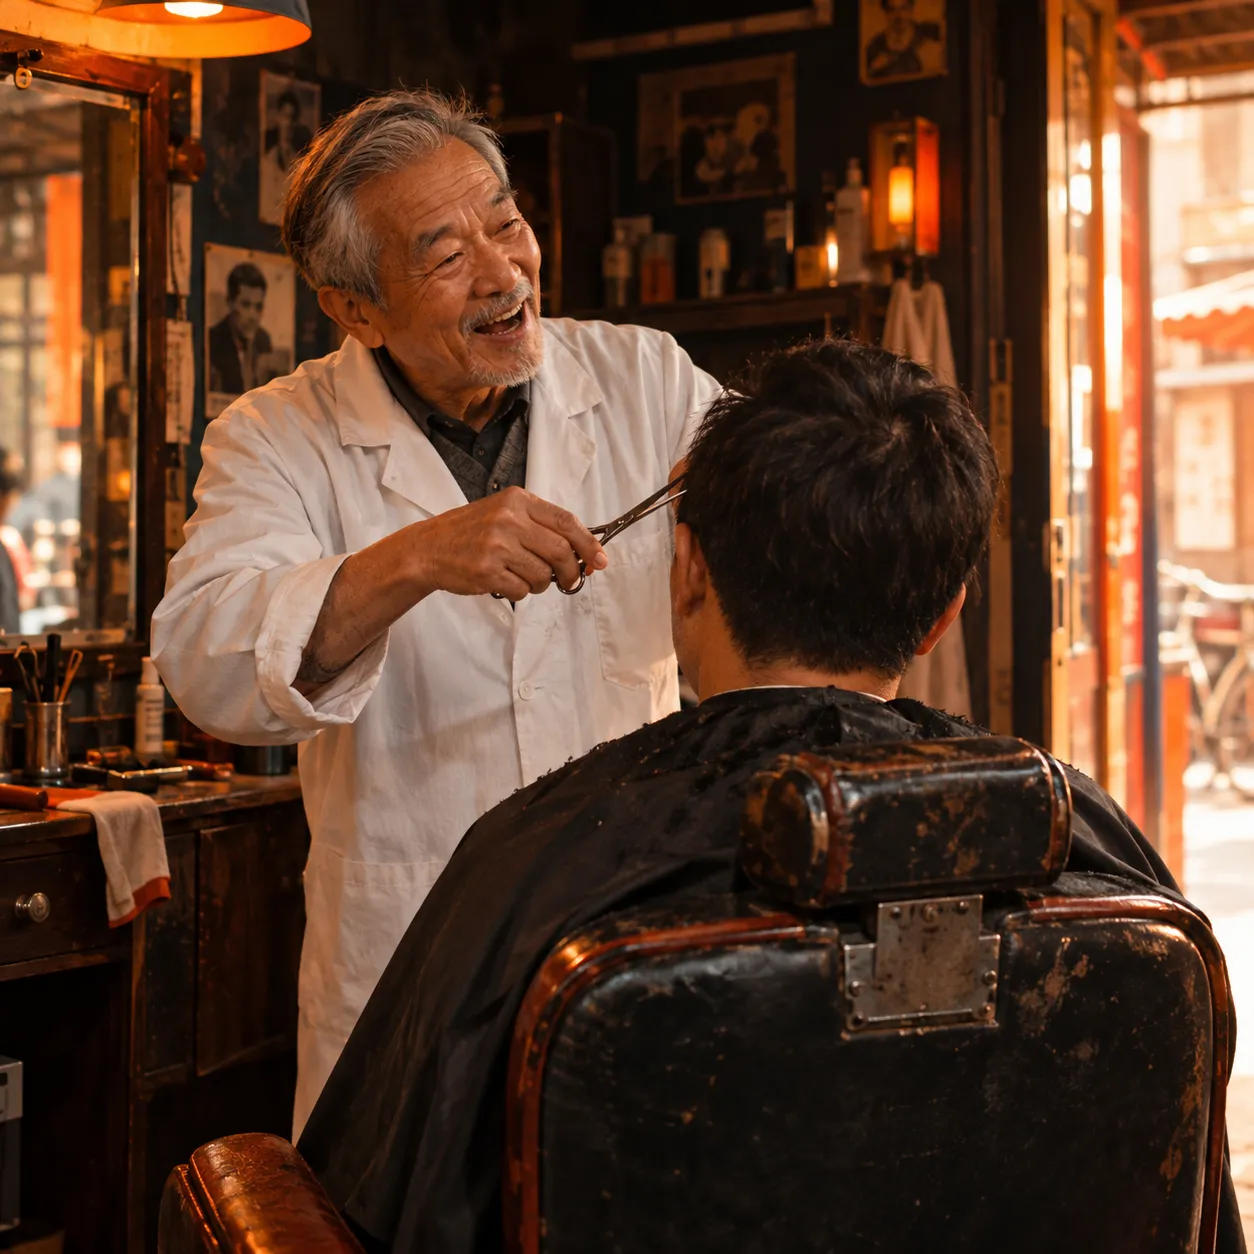 方言配音
换方言再说
- 上传
- 原视频,加一段方言或外语录音
- 先试
- 以工具内显示为准
- 小提醒
- 先拿十几秒试,再做整条
本页配图为示意,非 VEME 生成结果。
以工具内显示为准
照片声音,传前自查
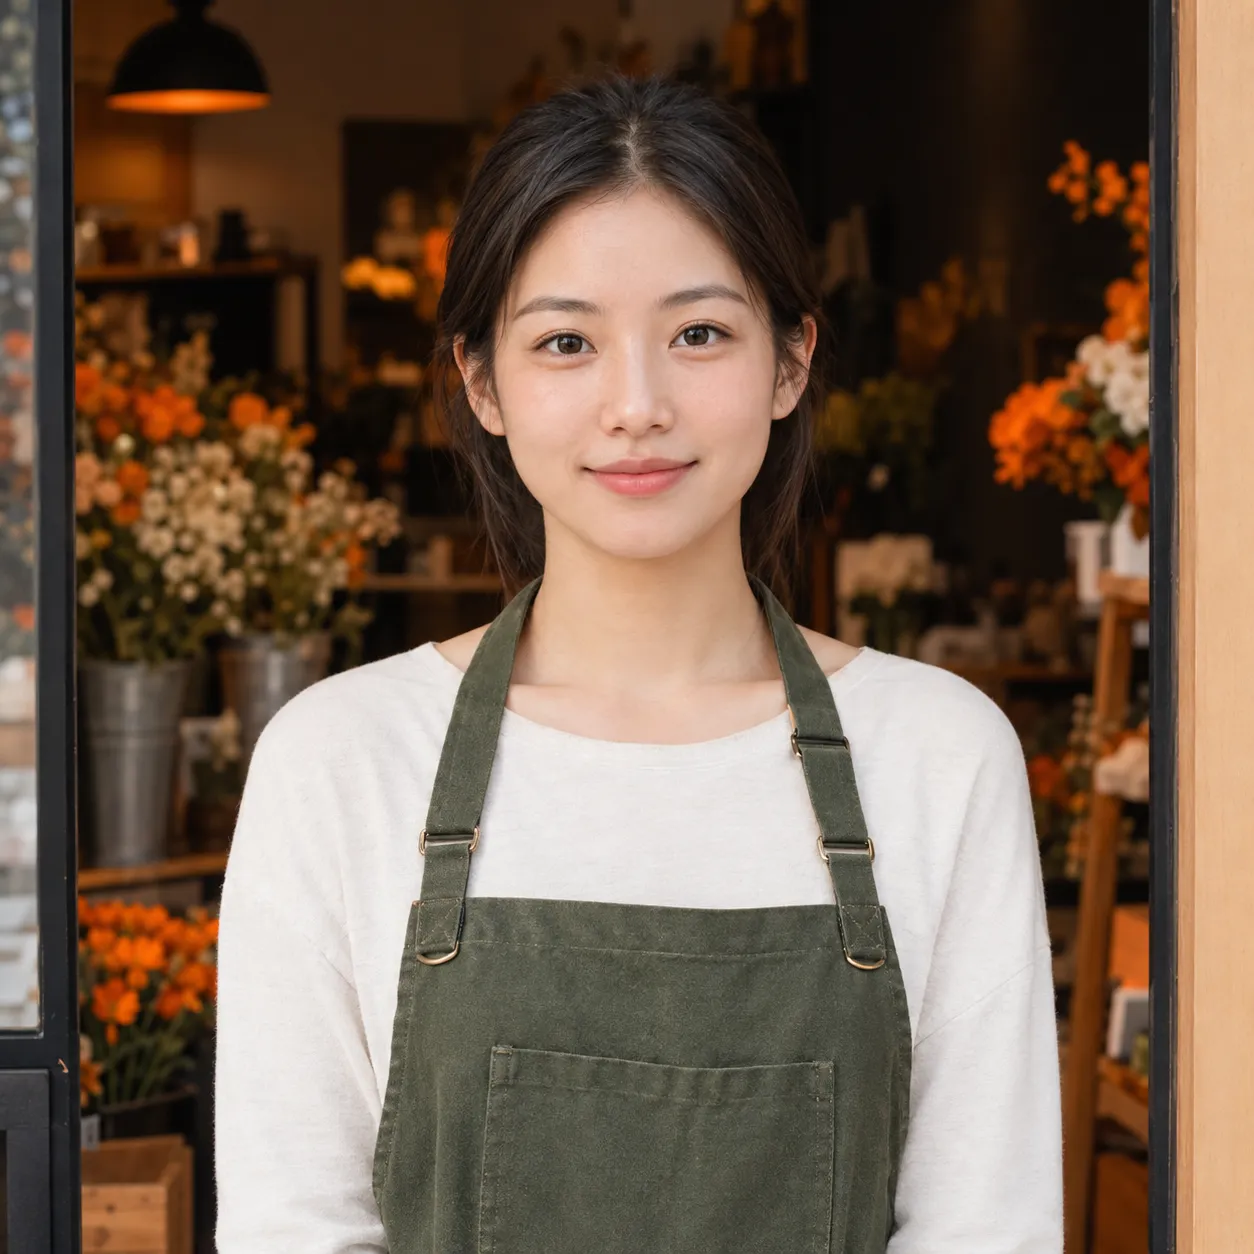
照片和视频
- 正脸,眼睛看镜头。
- 嘴边别挡东西:口罩、手、话筒、头发。
- 两边脸亮度差不多,别半张脸在阴影里。
- 视频里的人别猛地转头。
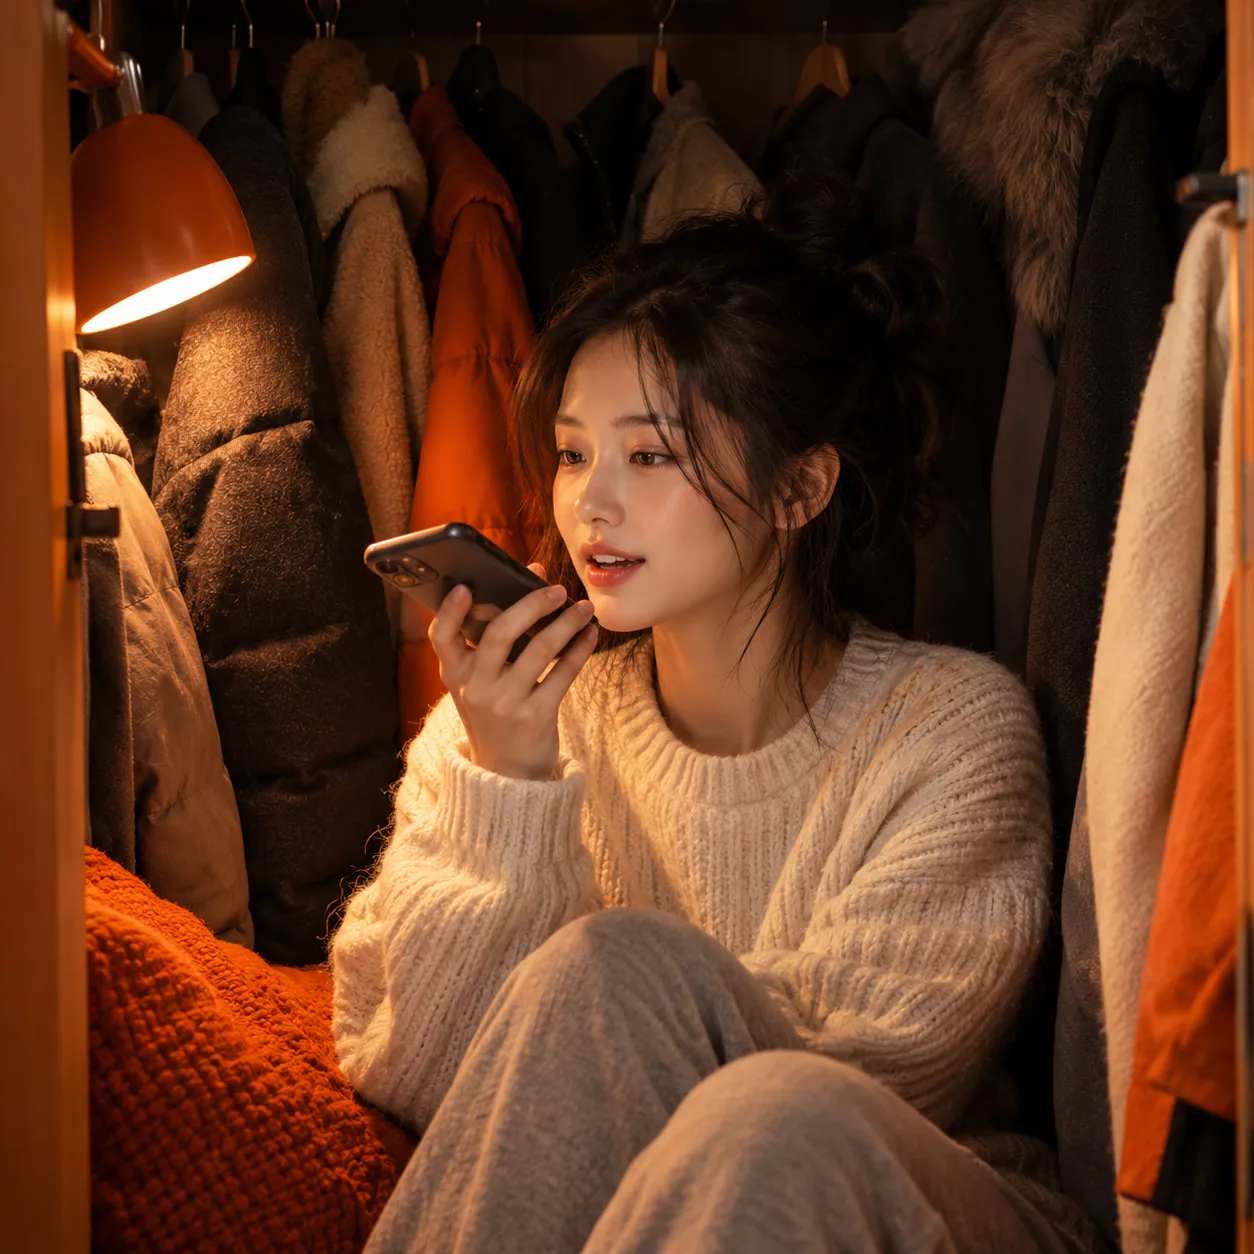
声音
- 只要人声,背景音乐越小越好。
- 找个不回音的地方录,挂满衣服的衣柜就很好用。
- 给视频换声音,新音频和原视频长度尽量接近。
- 一句一句说清楚,别吞字。
三个模型,按需挑选
| 模型 | 模型说明 | 适合做什么 | 额外能填 | 按钮积分 |
|---|---|---|---|---|
latentsyncReferenceAudio | 基于音频和人脸参考生成对口型视频 | 口播换声音,照片先试一版 | 无 | 以工具内显示为准 |
kling-avatar-v2-standardStart/EndAudio | 使用标准质量预设生成说话头像 | 照片说话、唱歌 | 语音描述(可选) | 以工具内显示为准 |
kling-avatar-v2-proStart/EndAudio | 使用更高质量预设生成说话头像 | 正式账号,画面要更细 | 语音描述(可选) | 以工具内显示为准 |
生成需要积分。请登录后查看工具内当前设置对应的费用;账户优惠和方案权益以界面及价格页为准。
以工具内显示为准
中文口型,几个难音
看对口型视频,眼睛都盯着嘴。中文有几类音,嘴型变化特别大。录音时照顾好它们,AI对口型出来才像真在说话。
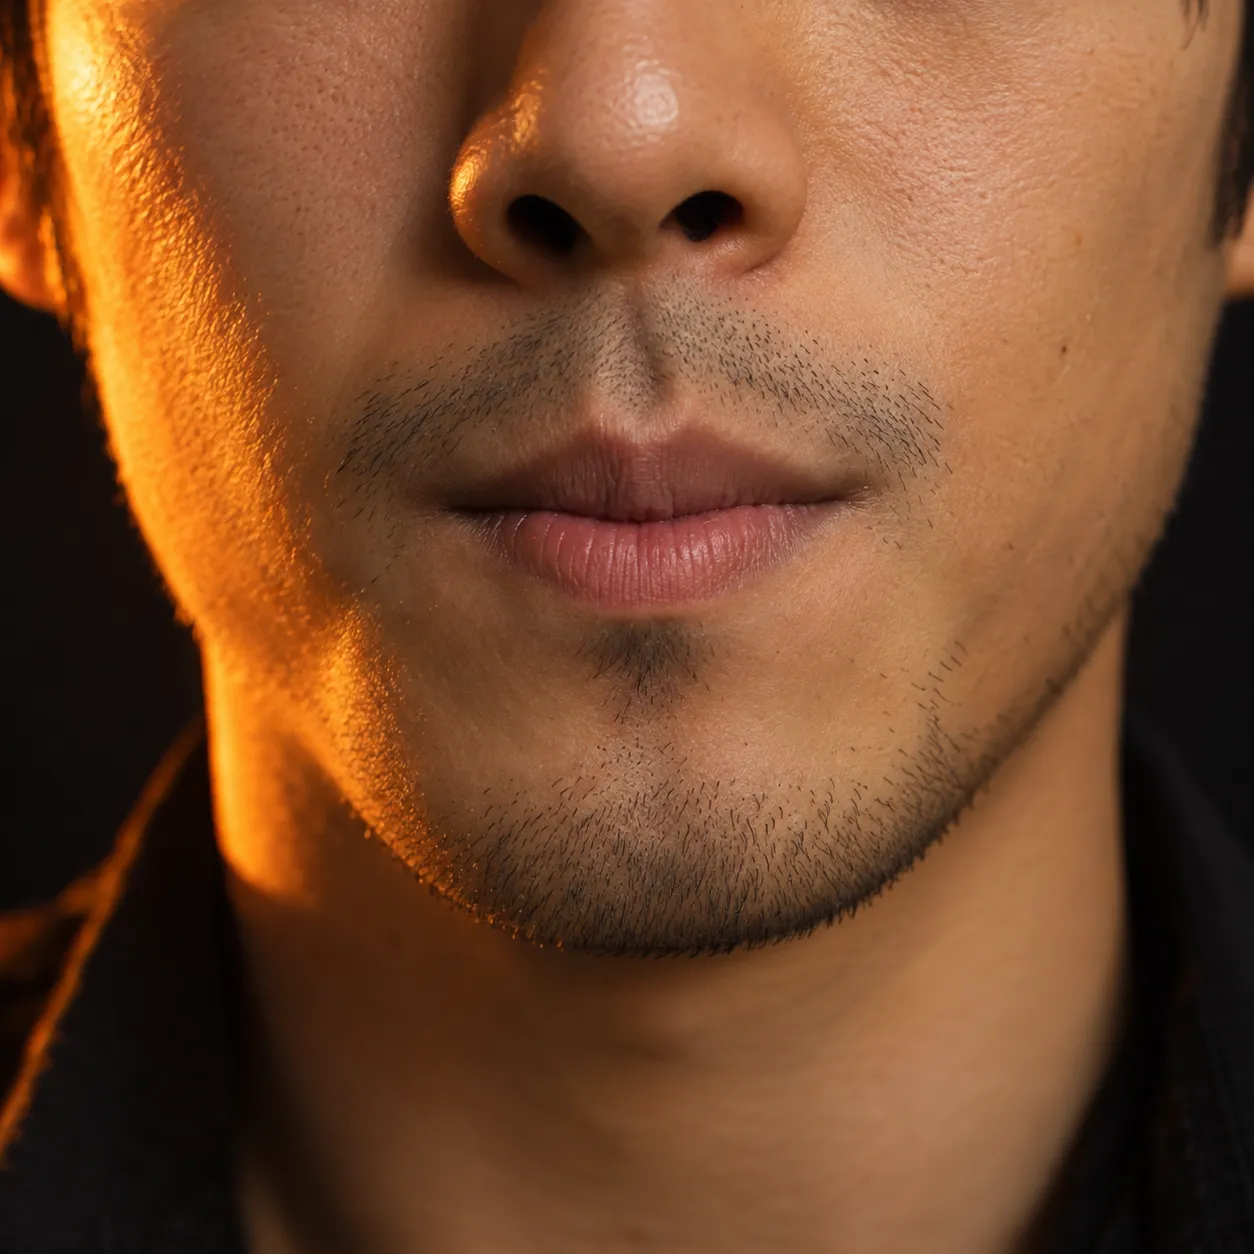
b、p、m 要闭嘴
「爸爸」「跑步」「妈妈」,嘴唇得碰一下再张开。咬字清楚,别一口带过。
翘舌和平舌
zh、ch、sh 和 z、c、s 嘴型很像,语速一快就糊。绕口的词,换个说法更稳。
a、o 张得最大
拖长的「啊」「哦」,嘴张得最开。出片后先看这几处,时机对不对一眼就知道。
唱歌的长音
一个字唱好几拍,嘴型要一直撑住。挑伴奏轻、咬字清楚的版本,有干声就用干声。
先拿授权,再发视频
AI对口型做出来的,是一个人在说话。玩笑开过头,就成了冒充。发之前记住三件事。
只用自己的脸和声音
上传的照片和声音,需要是你本人的,或已经拿到本人同意。朋友的也先问一句。不要用公众人物、明星的脸或声音。
标上「内容由AI生成」
《人工智能生成合成内容标识办法》2025年9月1日起施行。发抖音、视频号、小红书时,用平台的 AI 内容声明。
不冒充,不骗人
不让人「说」他没说过的话,不做假带货、借钱、求助这类内容。
工具只管把嘴对上声音。视频能不能发,你自己把关。
AI对口型常见问题
在国内能直接打开用吗?
可以。用浏览器打开就行,整个流程都在网页里做完,不用装软件。网络不同,打开速度会有差别。
对口型视频发抖音要标AI吗?
要标。合成的人脸、人声都属于需要标识的内容。发布时在作者声明里选「内容由AI生成」,入口位置随抖音版本可能会变。
我能用明星或朋友的照片做吗?
明星不行。按《民法典》第一千零一十九条,用技术手段伪造别人的肖像属于侵权。朋友的照片,先拿到对方同意。
能对粤语、四川话这些方言吗?
可以试。口型同步支持多语言音频,但方言口音差别大。先传十几秒,看嘴型跟不跟得上,再做整条。
一条视频最长能做多长?
时长上限以上传页面显示为准。建议先用十几秒的素材试,素材越长,积分可能越多。
宠物照片也能开口唱歌吗?
能。脸正、嘴部清楚的宠物照片效果更好。卡通形象差别比较大,先拿一张试试。
做一条要花多少积分?
生成需要积分。请登录后查看工具内当前设置对应的费用;账户优惠和方案权益以界面及价格页为准。